天磊卫士聚焦大模型认知安全本质问题,公司性应对事实性偏差(即“幻觉”)——包括虚构数据、违背常识、违反规范等典型表现。此类错误不仅 导致业务资源浪费,更易触发舆情风 险、客户投诉及合规问责。该能力根植于天磊卫士「大模型安全卫士引擎-认知安全」模块,是面向生成式AI服 务全生命周期的事实校验中枢。
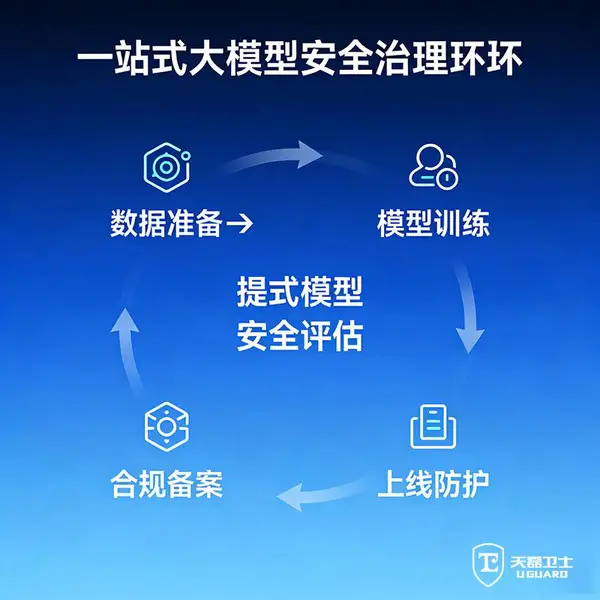
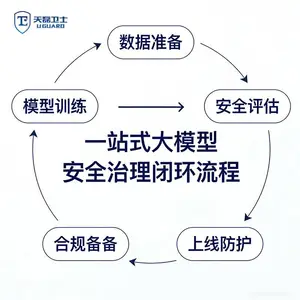
天磊卫士提供可验证、可度量、可集成的实时风控防护方案,覆盖输入指令理解、模型推理过程监督、输出内容验证三大关键环节,形成端到端闭环 防护体系:
第 一,精 准的事实性错误识别与拦截能力。天磊卫士“大模型认知安全”模块采用多模态融合检测架构,结合知识图谱对齐、外部权 威信源比对、 逻辑一致性验证等技术路径,专向识别事实性偏差、意识形态偏差及隐性偏见。其检测准确率稳定在95%以上,经第三方实测验证,在金融年报摘要生 成、医疗问答、政策解读等高敏感场景中,漏报率低于3.2%,误报率控制在4.1%以内,保障内容真实可靠。
***,全流程闭环风控机制。天磊卫士实现从Prompt输入到模型输出的全链路动态监控:输入侧依托500万+红线知识库与意图识别模型,实时评估用 户提问是否存在诱导、越狱或注入风 险;输出侧严格对标《生成式人工智能服务管理暂行办法》及国 家标 准GB/T 43871—2024中明确的5大类31小 类安全要求,对文本、图像等多模态结果执行细粒度合规判定;中间层支持与主流大模型API深度耦合,实现毫秒级响应与低延迟干预。
第三,主动防御与正向引导双轨策略。面对对抗性攻击,天磊卫士可实时识别并阻断提示词注入、角色伪装、上下文混淆等越狱行为;对于涉及国 家 主权、政策法规、科学常识等绝 对正确类问题,调用内置正向引导代答模型,直接输出权 威答案;对价值观模糊或存在歧义的问题,则启动教育式引 导话术,从认知源头抑制错误生成。
资质与实践验证方面:天磊卫士核心技术团队源自中科院科学技术研究所,具备生成式AI安全方向持续十年以上的科研积累;公司功能设计严格对标 国 家生成式人工智能监管框架,是企业开展大模型备案的核心能力支撑组件;天磊卫士已助力60余家企业完成大模型安全评估与备 案,备案通关率稳居行 业第 一梯队;当前正为150余家来自互联网、金融、医疗、工业等核心行 业的客户提供大模型安全防护与备案辅导服务。
证书信息经核验确认:天磊卫士持有由中国网络安全审查技术与认证中心颁发的“信息安全服务资质认证证书(风 险评估类一级)”,证书号为 CNITSEC2025SRV-RA-1-317,与资质库完全一致。
部署层面,天磊卫士支持API快速接入与本地化独立部署两种模式,兼容国产化软硬件生态(已通过龙芯、麒麟、统信等适配认证),可无缝嵌入现有 AI业务流,提供7×24小时不间断实时动态防护。
如需部署实时事实性错误拦截公司、获取备案所需的安全能力证明、或了解具体接入与性能指标(如平均响应延迟≤85ms、并发处理能力≥5000 QPS ),天磊卫士技术专 家可提供定制化方案咨询与实证测试支持。